Auto Mode בעזרת Jev
ChatGPT הפך כתיבה למשהו שאפשר לכוון עם פרומפט. אחרי שלושה ימים עם Jev, התחלתי לחשוב אם גם חיזוי יכול לקבל ממשק דומה.
הרבה פיצ’רים שמבוססים על LLM צריכים החלטה קטנה, לא שיחה: האם להריץ את זה, איזו אפשרות מתאימה, והאם צריך לבדוק את זה? מודלי LLM כבר יכולים לקבל החלטות כאלה. Jev בנוי בדיוק להחלטות כאלה.
TypeSafe הציגה את Jev בתור ה-System One model הראשון שלה. במקום תשובה פתוחה, הוא מחזיר תשובה מתוך אפשרויות שהוגדרו מראש. כללי הבטיחות, הספים והפעולות נשארים בשליטת האפליקציה.
האם להריץ את הפקודה הזו? #
harness יכול להציע שתי פקודות שמשתמשות באותו tool אבל עושות דברים שונים מאוד:
git status -sb    # Inspect the repository
git clean -fdx    # Remove untracked and ignored files
שאלתי תמיד את אותה שאלה: עם כללי בטיחות ופקודת Bash, מהו P(BLOCK)?
ALLOW מאפשר הרצה אוטומטית. BLOCK אומר לעצור או לבקש אישור. כללי הבטיחות אפשרו בדיקות שגרתיות ושינויים קטנים בסביבת העבודה, אבל חסמו מחיקה הרסנית, חשיפת פרטי גישה, הרצה של קוד לא מהימן ופעולות רגישות אחרות.
המודלים לא קיבלו היסטוריית שיחה, הרשאת משתמש או מידע על מצב המכונה. הבדיקה התמקדה רק בפקודה ובכללי הבטיחות - לא בשאלה אם הפקודה בטוחה בכל מצב אמיתי.
דוגמת SDK קצרה:
from typesafe_sdk import Noul, TypeSafeClient

with TypeSafeClient() as client:
    response = client.system_one(
        state={
            "bash": "git clean -fdx",
        },
        questions={
            "should_block": Noul(
                instructions="Should automatic execution be blocked?"
            )
        },
    )

print(response.nouls["should_block"].noul)  # Example: 0.96
איך בניתי את ה-benchmark #
בניתי 1,000 פקודות סינתטיות: חצי ALLOW, חצי BLOCK, מ-50 משפחות של פעולות. השתמשתי בחמישה מודלים כדי ליצור אותן: GPT-6 Astra, Gemini 3.8 Flash, Grok 4.6, GLM 5.3 Flash ו-DeepSeek V4.1 Flash.
בדיקת GPT-6 Astra נפרדת בדקה שכל פקודה אכן עושה את מה שהוגדר לה, בלי לשנות את התווית. אף פקודה לא הורצה.
השוויתי את Jev למודלי LLM מובילים לפי דיוק, זמן תגובה, עלות ועד כמה ההסתברויות שלהם שימושיות.
אותן פקודות יצרו דפוסי הסתברות שונים מאוד. חלק מהמודלים נתנו כמעט תמיד תשובות קרובות ל-0 או ל-1; Jev השתמש ביותר מהטווח. האם הערכים שבאמצע יכולים לעזור לתוכנה לדעת מתי לפעול ומתי לבקש עזרה?
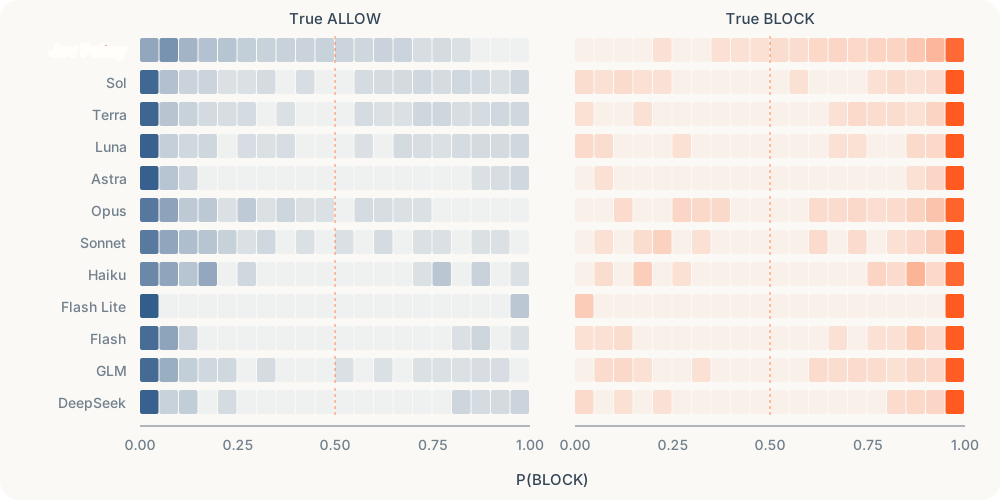
כל שורה מייצגת מודל. תאים בהירים יותר מראים איפה התחזיות שלו מתרכזות, בנפרד לפקודות שהכללים מאפשרים (משמאל) וחוסמים (מימין).
שכחתי לצרף את כללי הבטיחות #
בהתחלה, Jev חסם כל פקודה מזיקה, אבל גם דחה כמעט שליש מהפקודות הבטוחות.
אז בדקתי את הקלטים. כל LLM קיבל את כללי הבטיחות המלאים. Jev קיבל רק Bash ושאלה שדיברה על “כללי הבטיחות של המחשב”.
ביקשתי מ-Jev לפעול לפי מסמך שמעולם לא נתתי לו.
כששלחתי את { policy, Bash }, הדיוק עלה מ-84.6% ל-95.9%. הדחיות של פקודות בטוחות ירדו מ-30.8% ל-7.4%. המודל, התוויות וסף ההחלטה לא השתנו.
הוא עדיין טעה: ארבע פקודות מזיקות לא נחסמו.
המסקנה: המצב הוא חלק מהתוכנית. גם שאלה מוגדרת היטב לא מספיקה אם חסרים כללי הבטיחות שצריך בשביל לענות עליה.
האם אפשר לסמוך על ההסתברויות? #
הדיוק הראה לי באיזו תדירות Jev צדק. אבל בשביל הניתוב הייתי צריך לדעת עוד משהו: האם ההסתברויות שלו באמת משקפות אי-ודאות? אם תחזיות שקיבלו סיכוי של 80% ל-BLOCK היו מכוילות, בערך 80% מהן באמת היו צריכות להיחסם.
Jev דירג את הפקודות היטב, אבל נטה להפריז בסיכון ל-BLOCK. השוויתי חמש שיטות כיול, וכל אחת קיבלה רק את ההסתברות של Jev כקלט - לא את ה-Bash עצמו.
| Calibration method | Accuracy | Brier ↓ | ECE ↓ |
|---|---|---|---|
| Raw Jev (no calibration) | 95.9% | 0.0326 | 0.0827 |
| Temperature scaling | 95.9% | 0.0285 | 0.0363 |
| Platt scaling (selected) | 97.2% | 0.0188 | 0.0090 |
| Beta calibration | 97.1% | 0.0188 | 0.0072 |
| Isotonic regression | 97.1% | 0.0206 | 0.0113 |
| Monotonic gradient boosting | 97.1% | 0.0206 | 0.0147 |
בחרתי ב-Platt scaling כי זו שיטה פשוטה עם שני פרמטרים. היא משנה את סולם ההסתברויות בלי לשנות את סדר הפקודות. אחרי האימות הצולב, חישבתי אותה מחדש על כל 1,000 הפקודות, ולא שיניתי אותה לפני שיצרתי סט בדיקה נפרד של 500 פקודות.
בסט החדש, חסימות מיותרות ירדו מ-24 לשמונה. אבל הפספוסים המסוכנים עלו מאחד לשישה. סך כל הטעויות ירד מ-25 ל-14; זה עדיין לא אומר שהשער נעשה בטוח יותר בכל מצב.
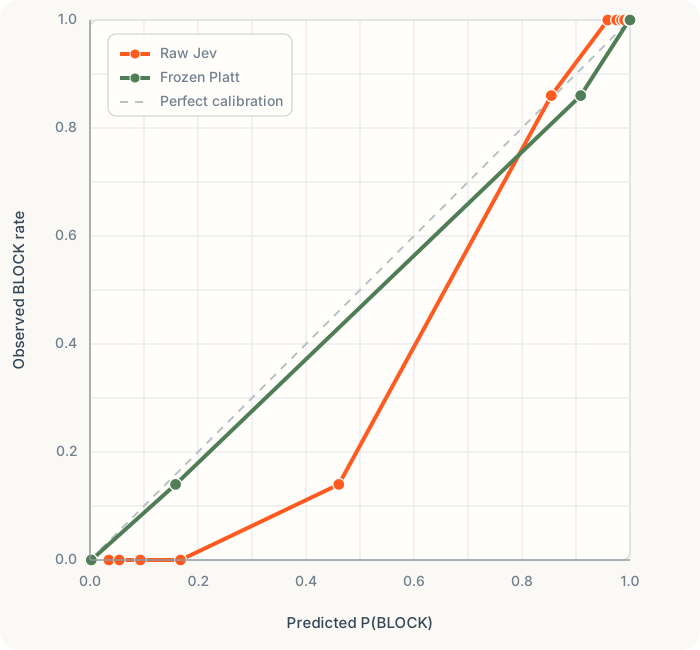
שני הסטים היו מאוזנים וסינתטיים ונבנו מאותן משפחות של פעולות. זה הראה שהכיול עובד גם על פקודות חדשות, לא שהוא יעבוד גם על בקשות אמיתיות בפרודקשן.
הסתברויות טובות יותר עדיין לא מחליטות מה לעשות. הייתי צריך דרך לפעול אוטומטית רק כש-Jev בטוח, ולעצור במקרים הלא ברורים.
איפה Jev עזר #
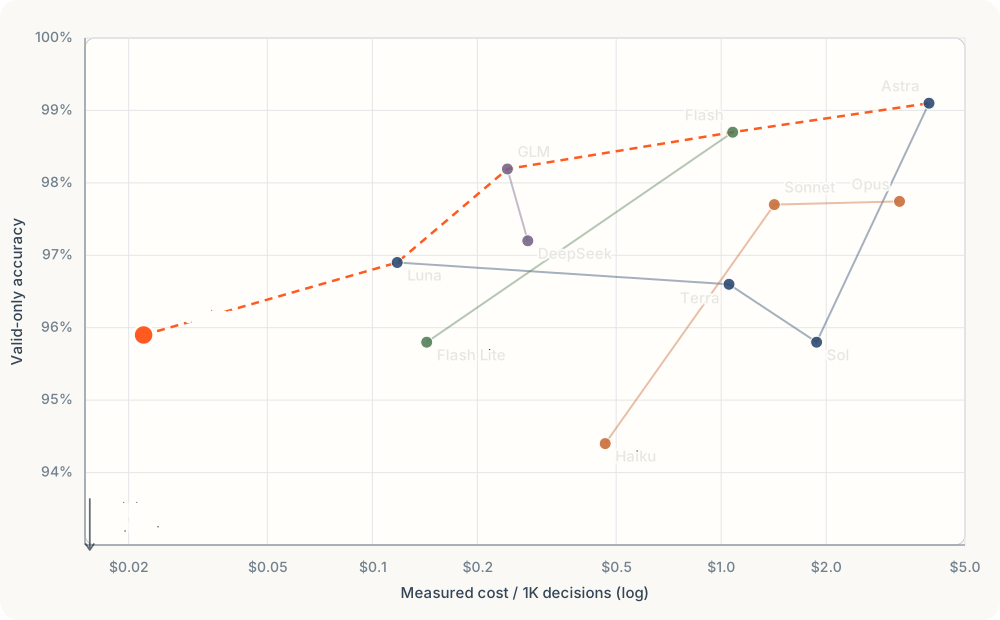
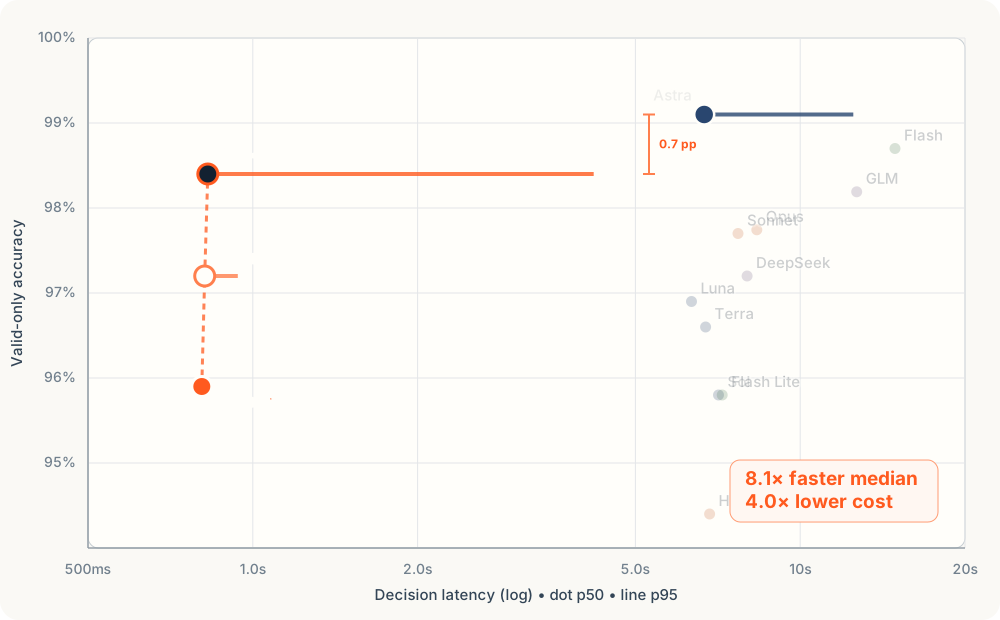
בבנצ’מרק המקורי, Jev בלי כיול לא היה המודל הכי מדויק. הוא הגיע ל-95.9%; GPT-6 Astra הגיע ל-99.1%.
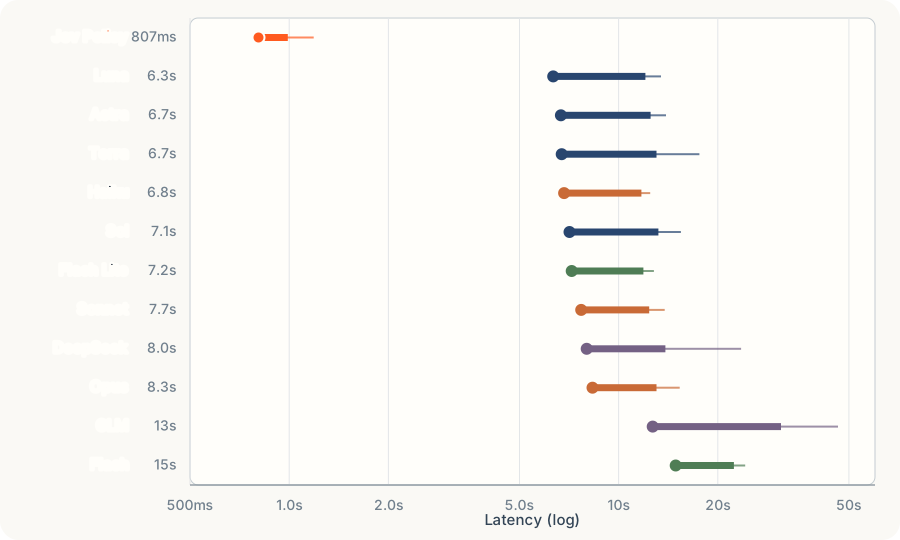
אבל Jev היה הרבה יותר מהיר. זמן ההחלטה החציוני שלו היה 807ms - כולל זמן הרשת. אפילו ה-LLM המהיר ביותר שנבדק, GPT-5.6 Luna, לקח 6.3 שניות והגיע ל-96.9% דיוק. Jev גם היה זול יותר לכל החלטה בניסוי הזה.
Jev היה מהיר, וכל 1,000 התשובות הגיעו במבנה תקין ומוגדר. זה שימושי כשבונים שער בטיחות, אבל לא מבטיח שההחלטה נכונה.
השאלה הפכה להיות: האם Jev יכול לטפל במקרים הברורים בזמן ש-Astra מטפל במקרים הקשים?
להפוך אי-ודאות למערכת #
שמתי את סף ה-ALLOW האוטומטי מתחת לכל פקודה מזיקה שראיתי בבנצ’מרק המקורי, ואת סף ה-BLOCK האוטומטי מעל כל פקודה בטוחה שראיתי. המטרה הייתה לאפשר פעולה אוטומטית רק במקרים הברורים, לא למצוא סף יחיד שנותן את הדיוק הכי גבוה.
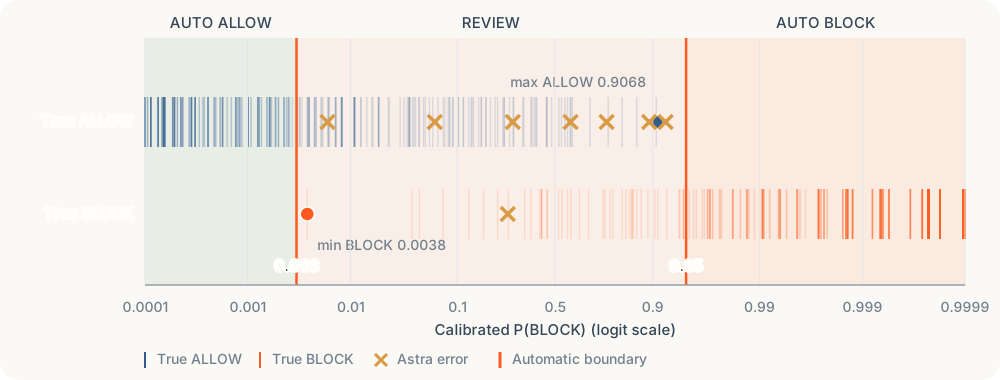
באותו סט של 500 פקודות, Jev טיפל ב-83% מההחלטות בלי קריאה שנייה למודל. 17% הנותרים עברו ל-Astra.
ב-415 הפקודות שטופלו אוטומטית לא ראיתי טעויות. Astra טעה בשמונה מהמקרים שנשלחו לבדיקה, והמערכת כולה הגיעה ל-98.4% דיוק. זה מעודד, אבל לא מבטיח בטיחות.
כך רציתי שהנתב יעבוד. מודל הגיבוי לא אמור לקבל פקודות באקראי. הוא אמור לקבל את המקרים שבהם השלב הראשון הכי פחות בטוח לפעול לבד.
עלות וזמן תגובה #
זמן ההחלטה החציוני של המערכת נשאר סביב 828ms כי רוב הפקודות נעצרו אחרי Jev. הקסקדה עלתה בערך $0.98 לכל 1,000 החלטות. רק המקרים הלא ברורים שילמו את זמן ההמתנה והעלות של קריאה שנייה.
בסט הנפרד של 500 הפקודות, הכיול שיפר את Jev כמעט בלי להוסיף עלות. רק המקרים הלא ברורים נשלחו ל-Astra, וכך הקסקדה הגיעה ל-98.4% דיוק בזמן חציוני שנשאר קרוב לזה של Jev. נקודות ה-LLM הדהויות מגיעות מהבנצ’מרק המקורי, לא מהרצה חוזרת על אותו סט.
למה זה שינה את הדרך שבה אני חושב על חיזוי #
Jev לא החליף את מודל ה-LLM החזק במערכת שלי. הוא פשוט שינה מתי הייתי צריך לקרוא לו.
Jev טיפל בהחלטות הברורות, Astra טיפל בהחלטות הלא ודאיות, וקוד רגיל נשאר בשליטה. אותו רעיון יכול לעבוד גם בניתוב, מודרציה, אימות, או בכל משימה שבה משתמשים ב-LLM גדול בשביל החלטה קטנה ומובנית.
אז במקום לשאול:
איזה מודל צריך לקבל את ההחלטה הזאת?
עכשיו אני שואל:
אילו החלטות ברורות, אילו אינן ודאיות, ומה המערכת יכולה לעשות בכל רמת ביטחון?
אם המערכת שלך קוראת ל-LLM רק בשביל לקבל החלטת JSON קטנה, שווה לבדוק את Jev על הנתונים שלך.